News
Fast-dLLMとは:NVIDIAらの拡散型LLM高速化(2025年5月)とその後
「27.6倍」は、A100で1,024トークンを生成する1つの条件での数字でした。拡散型LLMを速くするNVIDIAらの研究を、論文から読み直します。
2025年5月28日、香港大学、米NVIDIA、MITの研究者が「Fast-dLLM」という手法の論文をarXivに公開しました。拡散型の大規模言語モデル(拡散型LLM)の推論を、追加の学習なしで最大27.6倍速くできる、という内容です。
この記事は、2025年5月30日に中国のニュース記事をもとに紹介した内容を、2026年10月に論文と公式の公開資料で確かめ直したものです。旧記事にあった数字の取り違えや会社名の誤りを正し、その後の動きを加えました。
拡散型LLMとは:一語ずつではなく、まとめて埋めていく
ChatGPTなど一般的なLLMは「自己回帰型」と呼ばれ、文章を先頭から一語ずつ予測して書き進めます。これに対して拡散型LLMは、伏せ字(マスク)だらけの文章から始め、何段階かに分けて伏せ字を埋めていきます。画像生成で広く使われている拡散モデルの考え方を、文章に持ち込んだものです。
一度に複数の語を埋められるので、原理的には速く書ける可能性があります。2025年には、Inception Labsが商用の拡散型LLM「Mercury」を公開し、Google DeepMindは5月20日に実験的なモデル「Gemini Diffusion」のデモを発表しました。公開されている研究用のモデルとしては、中国人民大学とAnt Groupの「LLaDA」(2025年2月)や、香港大学とHuaweiの「Dream 7B」(2025年4月)があります。
ただ、論文によると、公開されている拡散型LLMの実際の推論速度は、自己回帰型に及ばないことが多くありました。理由は2つで、自己回帰型で一般的な高速化の仕組み「KVキャッシュ」が使えないことと、複数の語を同時に埋めると品質が落ちることです。
Fast-dLLMの2つの工夫
ブロック単位のKVキャッシュ
KVキャッシュは、すでに計算した注意機構の中間結果(キーとバリュー)を保存して使い回す仕組みです。拡散型LLMは文章の前後を同時に参照するため、厳密には使い回せません。Fast-dLLMは文章をブロックに分けて生成し、隣り合う段階の中間結果がほとんど変わらないこと(論文の図では類似度が1に近い)を利用して、近似的に使い回します。前の部分だけを保存する「PrefixCache」と、未確定の後ろの部分も保存する「DualCache」の2種類があります。
確信度による並列デコード
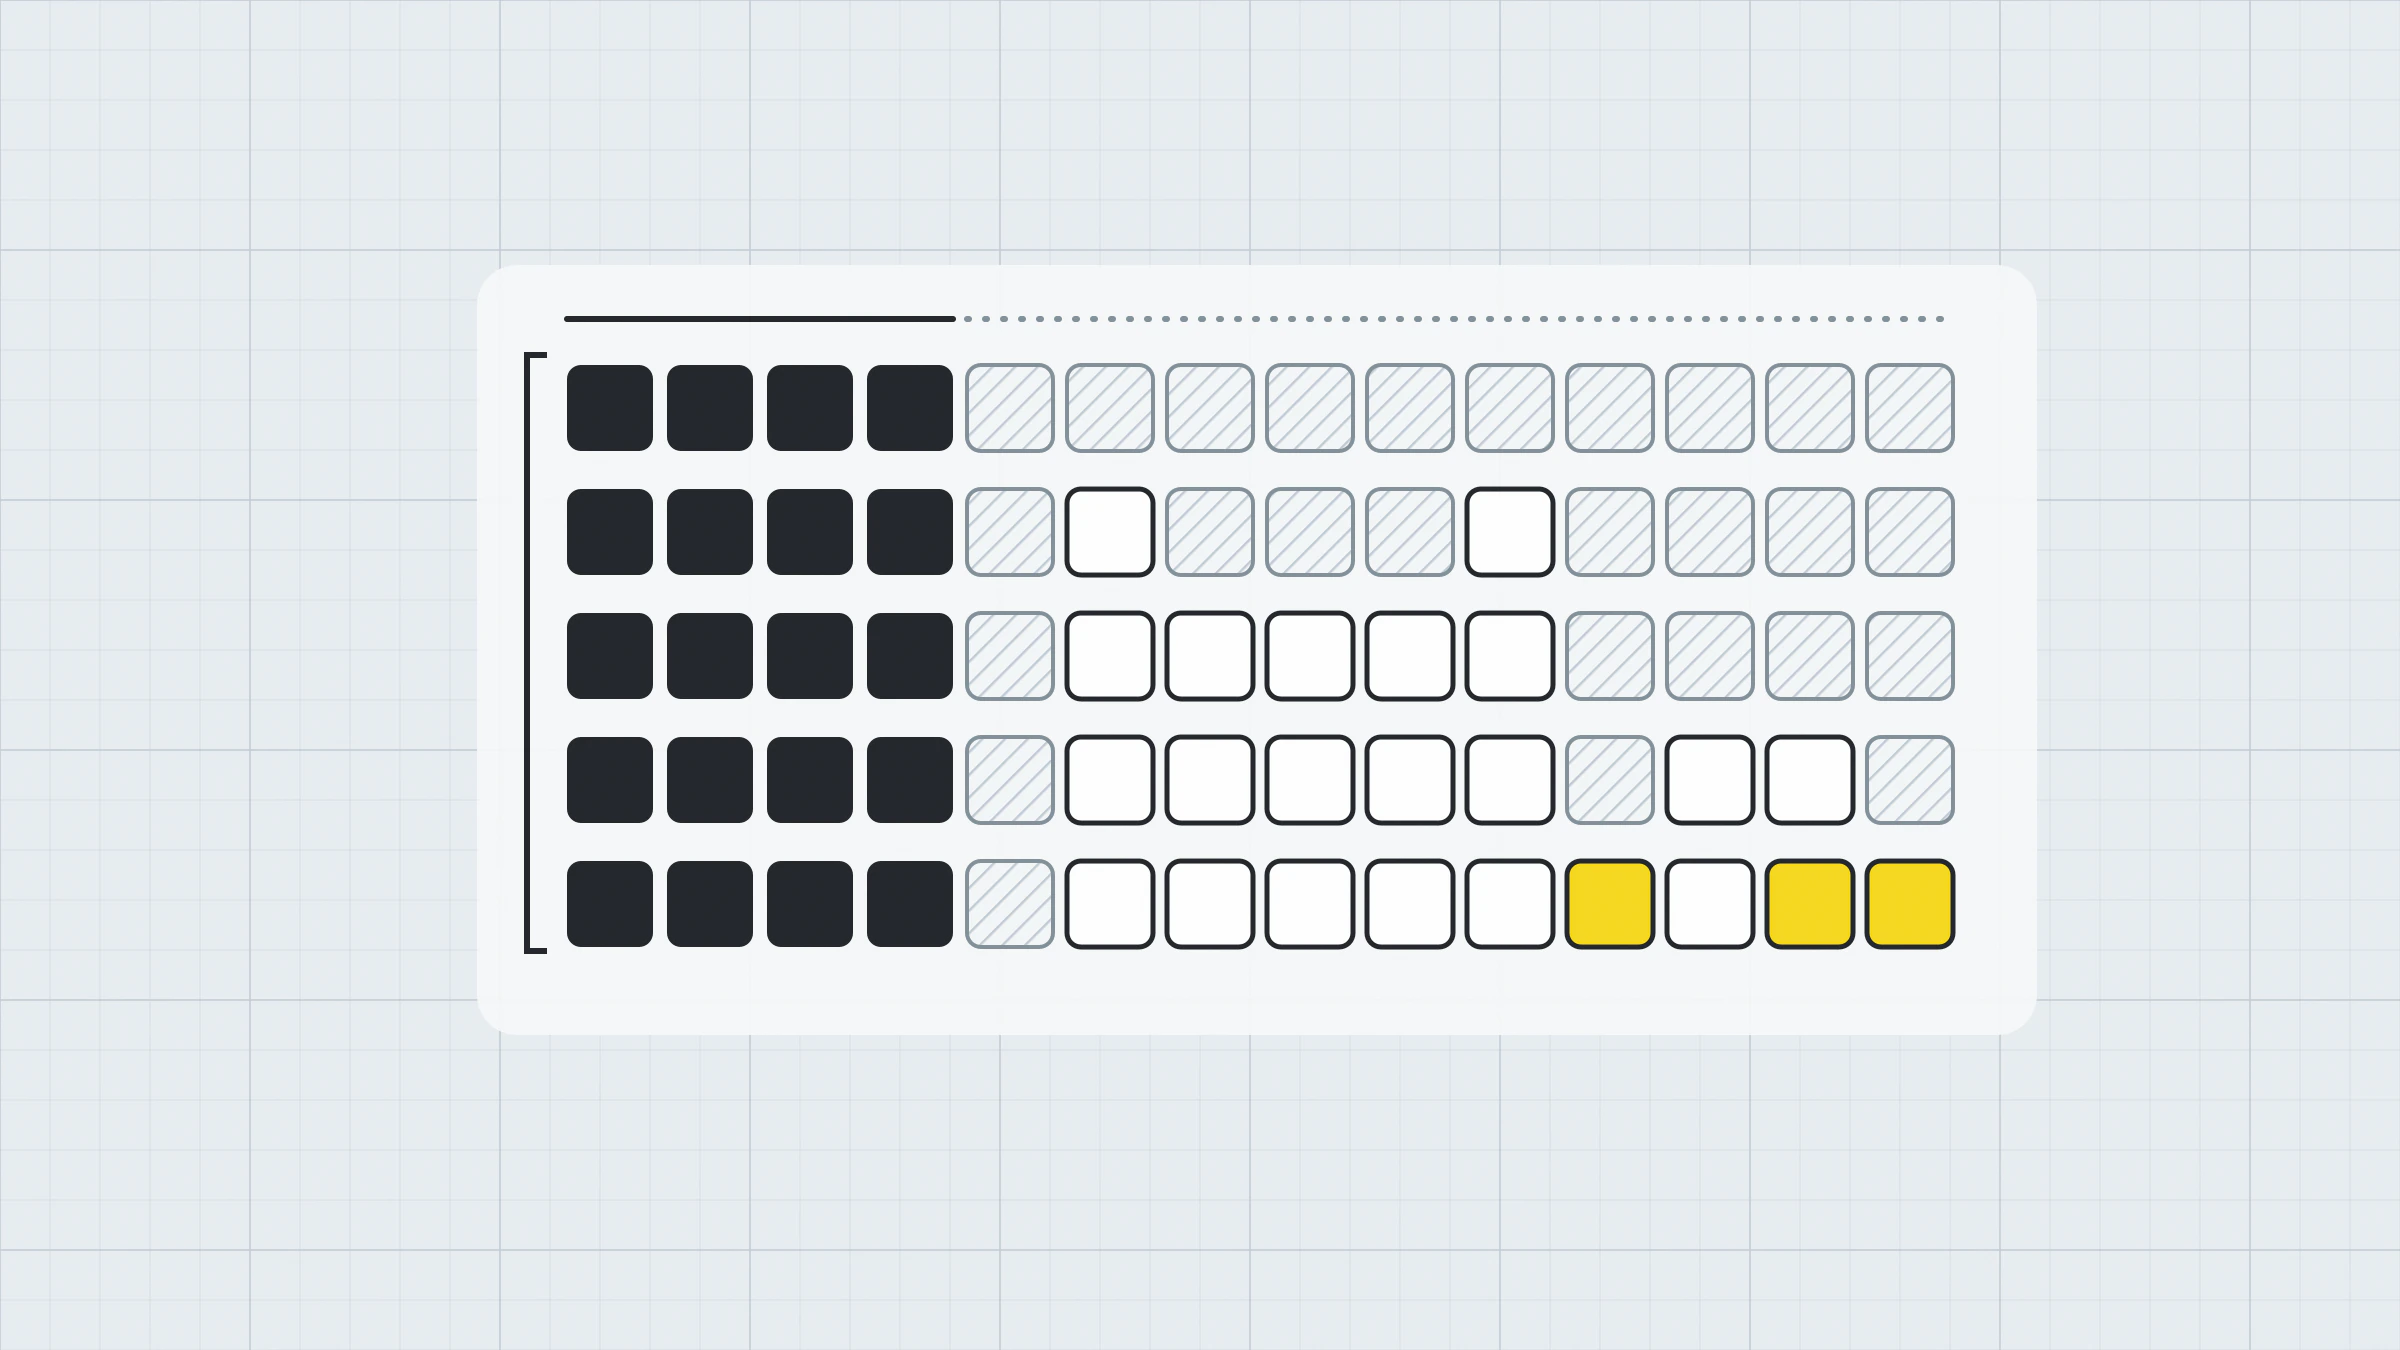
一度に複数の語を埋めるとき、すべてを確定させるのではなく、モデルの確信度がしきい値(標準は0.9)を超えた語だけを同時に確定させ、それ以外は次の段階に回します。論文は、確信度が十分に高く、一定の条件((n+1)ε≦1)を満たすときは、同時に確定させても一語ずつ最も確率の高い語を選んだ場合と結果が同じになる、という定理を示しています。ただし著者自身、理想化したモデルを前提にした定理だと注記しています。
どちらの工夫も、既存のモデルを学習し直さずに使えるのが特徴です。
「27.6倍」はどんな条件の数字か
27.6倍は、LLaDAで算数の問題集GSM8K(例題8問つき)を解き、最大1,024トークンを生成する条件で、DualCacheと並列デコードを組み合わせたときのスループット(1秒あたりの生成トークン数)の比です。毎秒0.7トークンが19.3トークンになりました。論文の図では、1問あたりの所要時間が266秒から12秒に縮んでいます。正答率は77.3%から76.0%に下がっています。実験はNVIDIA A100 80GBのGPUで行われ、この図の計測はバッチサイズ1です。
生成する文章が短いと、効果は小さくなります。論文の主な表(LLaDA)では次のとおりです。
| ベンチマーク(生成長) | 正答率(元→Fast-dLLM) | スループットの向上 |
|---|---|---|
| GSM8K 5-shot(256) | 79.3% → 78.5% | 8.1倍 |
| HumanEval(256) | 41.5% → 43.3% | 3.7倍 |
| HumanEval(512) | 43.9% → 44.5% | 4.0倍 |
その後の動き(2026年10月時点)
学会での採択
Fast-dLLMは機械学習の国際会議ICLR 2026に採択されました(GitHubでの告知は2026年1月26日)。
Fast-dLLM v2
2025年9月30日に続編の論文が公開されました。こちらは既存の自己回帰型モデル(Qwen2.5)を約10億トークンの追加学習で拡散型に作り替える方式で、「学習不要」ではありません。論文は、通常の自己回帰型のデコードに比べて最大2.5倍速いとしています。コードとモデルは2025年10月8日に公開され、v2もICLR 2026に採択されています。
派生と組み込み
2025年6月30日には、画像も扱う拡散型モデルLLaDA-Vに組み込まれ、推論の所要時間が約60秒から約6秒に縮んだと告知されました。2026年には画像と言語の拡散型モデル向けの「Fast-dVLM」(4月)、自動運転向けの「Fast-dDrive」(5月)が同じリポジトリで公開されています。一方、NVIDIAの製品(推論ソフトウェアのTensorRT-LLMやNIMなど)に組み込まれたという公式の発表は見当たりません。NVIDIAのニュースルームやブログでの発表もなく、あくまで研究成果としての公開です。
拡散型LLMの広がり
Google DeepMindのGemini Diffusionは、2026年10月時点でも公式ページで「実験的なデモ」とされています。公式の計測値は毎秒1,479トークン(オーバーヘッド0.84秒を除く)です。
Googleは2026年6月10日、Gemini Diffusionの研究をもとにしたGemma 4をベースにした実験的なオープンモデル「DiffusionGemma」を公開しました。Inception LabsはMercury 2(2026年2月24日)、Mercury 2.5(2026年9月8日)、Mercury 3(2026年10月19日)と新版を出し、LLaDAの開発陣は2025年12月に最大1,000億パラメータのLLaDA2.0を公開しています。
拡散型LLMが自己回帰型に取って代わるかどうかは、2026年10月時点でも決着していません。Fast-dLLMの意味は、拡散型の弱点とされてきた推論の遅さが、学習し直さなくてもかなり縮められることを示した点にある、と編集部は考えています。
AIを支えるハードウェアの話題はAI半導体の材料不足の記事で、Googleの実験的なAIサービスはGoogle Labsの解説で取り上げています。AIの性能をどう測るかについてはポケモンでAIを評価するベンチマークの記事、研究結果の読み方についてはMITの「ChatGPT脳」研究を読み直した記事もあわせてどうぞ。
Sources
- Wu, C. ほか「Fast-dLLM: Training-free Acceleration of Diffusion LLM by Enabling KV Cache and Parallel Decoding」(arXiv:2505.22618、v1 2025-05-28、v3 2025-07-03) (2026-10-29確認)(新しいタブで開きます)
- NVlabs「Fast-dLLM」プロジェクトページ (2026-10-29確認)(新しいタブで開きます)
- NVlabs「Fast-dLLM」GitHubリポジトリ(READMEのニュース欄:LLaDA-Vへの組み込み、ICLR 2026採択、Fast-dVLM、Fast-dDrive) (2026-10-29確認)(新しいタブで開きます)
- Wu, C. ほか「Fast-dLLM v2: Efficient Block-Diffusion LLM」(arXiv:2509.26328、2025-09-30) (2026-10-29確認)(新しいタブで開きます)
- Google DeepMind「Gemini Diffusion」 (2026-10-29確認)(新しいタブで開きます)
- Google「Gemini Diffusion: Google DeepMind's experimental research model」(2025-05-20) (2026-10-29確認)(新しいタブで開きます)
- Google「Introducing DiffusionGemma」(2026-06-10) (2026-10-29確認)(新しいタブで開きます)
- Inception「Diffusion at Scale: Introducing Mercury 3」(2026-10-19) (2026-10-29確認)(新しいタブで開きます)
- Nie, S. ほか「Large Language Diffusion Models」(LLaDA、arXiv:2502.09992、2025-02-14) (2026-10-29確認)(新しいタブで開きます)
- HKU NLP「Dream 7B」(2025-04-02) (2026-10-29確認)(新しいタブで開きます)
Newsletter
こうした発見を、メールで受け取りませんか。
新着製品と読みものを、週2回お届けします。